


自从开始工作以来,我就一直特别讨厌一种回答:当你问一个“为什么”的问题,对方回你一句“以前就是这样的”“一直都是这样做的”。每次听到这种回答我都火冒三丈,因为这根本没有回答问题,和 why 没有半毛钱关系。
但老实说,我一直没有细想过,这种回答背后代表的思维模式到底是什么,以及它和我的思路究竟哪里不相容。直到前几天听了今年图灵奖得主 Richard Sutton 上 Dwarkesh Patel 播客的那一期,刚才回味他解释 training 和 learning 区别的那段,我才突然意识到我为什么会如此厌恶这种行为。
Dwarkesh Patel 最近关于 AGI 的三期播客非常硬核,嘉宾除了 Richard Sutton,还有 Andrej Karpathy 和 Ilya Sutskever,内容既基础又哲学,整体基调是AGI 远不会这么快到来,基于 LLM 的路线也走不到 AGI。非常推荐大家去看/听一听,提前预警相当烧脑。
ok,回到正题。
Sutton 认为,AGI 最重要的能力是持续学习(continual learning),而这需要的是强大而纯粹的计算能力,类似下围棋的 AlphaZero。它那篇 2019 年的著名文章《 The Bitter Lesson 》被认为是当下 scaling law 叙事的思想源头之一,强调“通用方法(搜索和学习) + 可扩展计算”比事先灌输人类知识更重要。Sutton 的看法是,如果继续一味放大基于互联网语料的预训练(pre-training),边际收益会越来越差,甚至在方向上把我们锁死在“模仿人类文本”的路线上,而不是走向真正具备持续学习能力的智能。
在 Sutton 的定义里,LLM 不会“学习”,因为真正的学习只能从经验中,通过尝试和反馈来获得。这一段他反复解释了很久,Patel 和我才逐渐明白他的意思:核心就是 training 和 learning 的区别。Patel 提到,人类幼崽会通过模仿来学习(我想大家应该都听到过这种说法,而且和我一样直觉认为这个说法是对的),但Sutton 直接反驳——这里学习的关键不是模仿,而是真实世界对幼崽的反馈:如果达到了目标,幼崽就学到了新东西;没有达到目标,幼崽就换一种方式再试。模仿可以加速这个过程,但完全不是学习的关键。
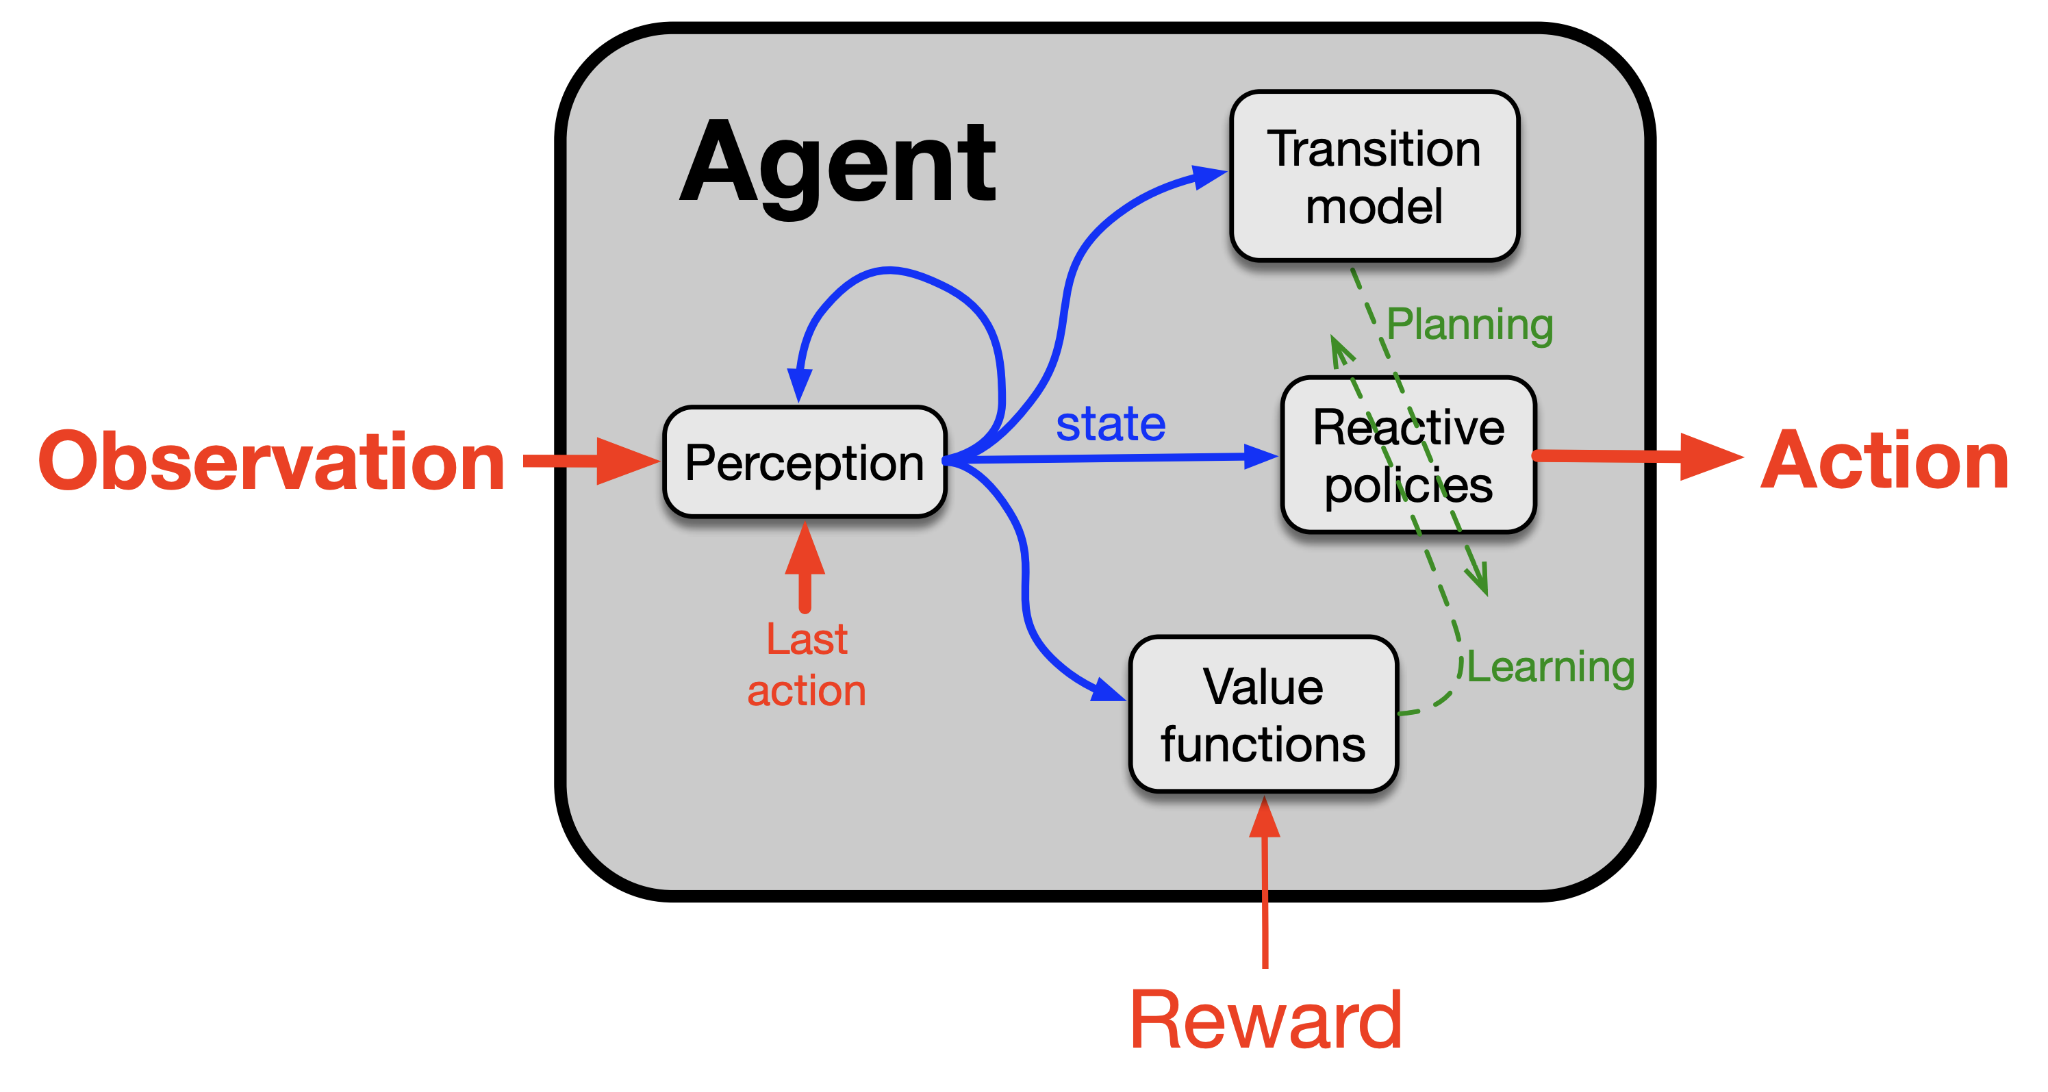
上面这张图有些晦涩,我自己的理解大致是:
通过 Observation 观察、Perception 感知现在的状态;
基于 Transition model 预测不同动作的结果,这个 model 可以来自已有知识(例如课本,对应 Supervised Learning),也可以来自规则(例如下围棋、打星际);
通过 Planning 规划,选择应对策略Reactive policies,然后执行 Action;
根据 Reward(事情有没有成功)来判断策略是否有效,从而完成学习。
在这张图里,现有的知识Transition model当然有用,但不是最关键的那部分。学习的核心,是动作Action获得的反馈Reward,以及基于反馈对策略的调整。
“以前就是这样的”“一直都是这样的”对应的,正是那一坨现有知识。当我们的目的异化成严格模仿现有知识,而不是“观察动作结果并基于反馈来调整”,学习就悄悄异化成了应试教育。
把这套框架套到今天的 LLM 上,会很容易看出差别。LLM 的训练,本质上是一个最小化损失函数(loss function)的过程,损失函数衡量的是模型输出与训练数据之间的差异。因此,LLM 的目标从来不是“找到真相”,而是生成在统计意义上最像训练数据里“标准答案”的回复。这就是 LLM 出现幻觉(hallucination)的根本原因——只要形式上足够像,它就已经“完成任务”了。
应试教育可以类比为针对人类的 Supervised Learning:它能让结果尽量和既有知识保持一致,也能在既有题库附近做到不错的“类比”,但一旦离开标准答案和既有套路,泛化能力就几乎为零。真正的学习,从来不止是“记住标准答案”,而是敢于做新动作,接受世界给你的真实反馈,并在这个循环里一点点变聪明。
同样地,职场里那种“以前就是这样”“一直按制度来”的思维,本质上也是在最小化一种“组织层面的损失函数”——不出错、不越线、不背锅。对不少人来说,这种对制度的服从和对既往做法的模仿,既能带来有效性,甚至还能带来某种目标感和意义感,但代价,是主动放弃了通过真实反馈完成自我更新的那部分学习与成长。